
Vi introduserer GPT‑5.3‑Codex‑Spark
Vi introduserer GPT‑5.3‑Codex‑Spark. OpenAI annonserte et partnerskap med Cerebras 14. januar. Fire uker senere lanserer de allerede den første integrasjonen, “en ultrarask modell for sanntidskoding i Codex”.
Til tross for at det heter GPT-5.3-Codex-Spark, er det ikke et rent akselerert alternativ til GPT-5.3-Codex – blogginnlegget kaller det “en mindre versjon av GPT-5.3-Codex” og klargjør at “ved lansering har Codex-Spark et 128k kontekstvindu og er tekstbasert.”
Jeg hadde litt forhåndsvisningstilgang til denne modellen, og jeg kan bekrefte at den er betydelig raskere enn deres andre modeller.
Slik ser hastigheten ut i Codex CLI:
Det var “Generer en SVG av en pelikan som sykler” – her er det gjengitte resultatet:
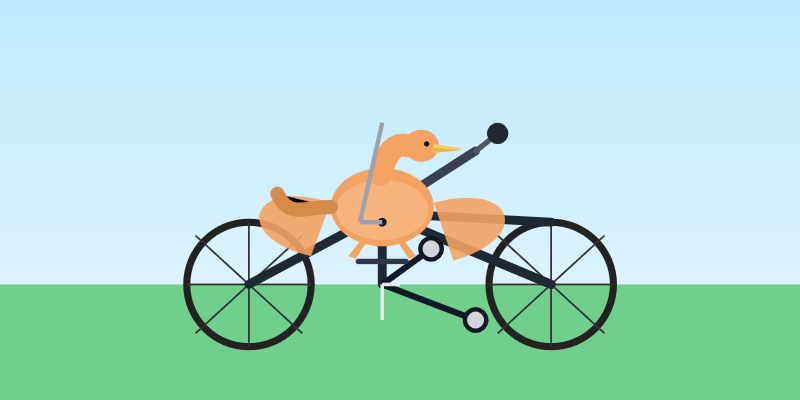
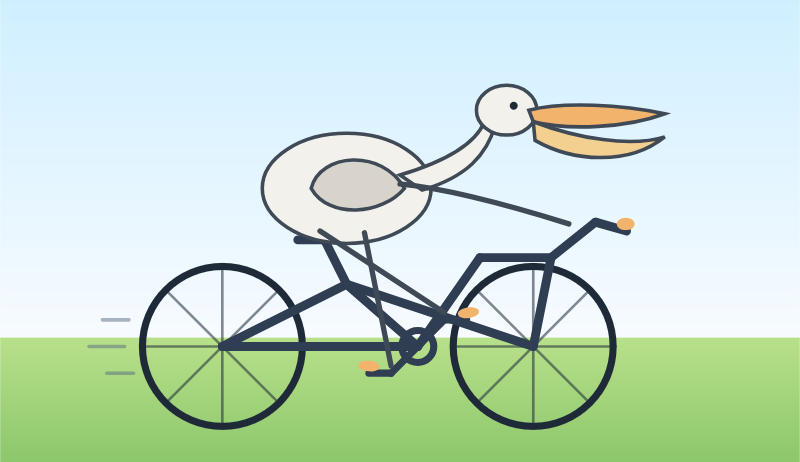
Sammenlign det med hastigheten til vanlig GPT-5.3 Codex-medium:
Betydelig tregere, men pelikanen er mye bedre:
Det som er interessant med denne modellen er imidlertid ikke kvaliteten, det er fart. Når en modell reagerer så raskt, kan du holde deg i flyttilstand og iterere med modellen mye mer produktivt.
Jeg viste en demo av Cerebras som kjører Llama 3.1 70 B til 2000 tokens/sekund mot Val Town tilbake i oktober 2024. OpenAI krever 1000 tokens/sekund for sin nye modell, og jeg forventer at den vil vise seg å være en voldsom nyttig partner for praktiske iterative kodingsøkter.


