
Послідовне хешування – веб-сайт Елі Бендерського
Ця публікація є вступом до узгодженого хешування, алгоритму для розробки хеш-таблиці так, що тільки невелика частина ключів повинна бути повторно обчислена, коли розмір таблиці змінюється.
Мотивуючий варіант використання
Припустімо, ми розробляємо кешуючий веб-проксі, але очікувані вимоги до пам’яті вищі, ніж може впоратися одна машина. Тому ми розподіляємо кеш між кількома машинами. Як ми це робимо? За наявності URL-адреси, як ми переконаємося, що ми можемо легко дізнатися, до якого сервера нам слід звернутися для потенційно кешованої версії?
Підхід, який одразу спадає на думку хешування. Давайте обчислимо числовий хеш URL-адреси та рівномірно розподілимо його між N вузлами (саме так ми називатимемо сервери в цій публікації):
hash := calculateHashFunction(url)
nodeId := hash % N
Цей процес працює, але виявляється, що він має серйозні недоліки в реальних програмах.
Проблема з наївним підходом хешування
Знову розглянемо наш випадок використання кешування; у реалістичному додатку в «інтернет-масштабі» одне з припущень, які ми зробили, явно не виконується — вузли кешу не є статичними. Нові вузли додаються до системи, якщо навантаження велике (або якщо в експлуатацію надходять нові машини); існуючі вузли можуть вийти з ладу або бути відключеними для обслуговування. Іншими словами, кількість Н у нашому додатку не є константою.
Проблема може бути очевидною зараз; щоб продемонструвати це безпосередньо, розглянемо реальну реалізацію hashitem за допомогою Go md5 пакет:
// hashItem computes the slot an item hashes to, given a total number of slots.
func hashItem(item string, nslots uint64) uint64 {
  digest := md5.Sum(()byte(item))
  digestHigh := binary.BigEndian.Uint64(digest(8:16))
  digestLow := binary.BigEndian.Uint64(digest(:8))
  return (digestHigh ^ digestLow) % nslots
}
Термінологія трохи скоригована:
- Замість того, щоб urlми будемо посилатися на загальний пункт
- «Слот» — поширене поняття в хеш-таблицях: our hashitem обчислює номер слота для елемента, враховуючи загальну кількість доступних слотів
Скажімо, ми почали з 32 слотів і хешували рядки "привіт",
"послідовний" і "бабак". Отримуємо такі слоти:
hello       (n=32): 4
consistent  (n=32): 14
marmot      (n=32): 5
Тепер припустимо, що додано ще один вузол і підсумок nslots зростає до 33. Знову хешуємо наші елементи:
hello       (n=33): 23
consistent  (n=33): 18
marmot      (n=33): 31
Всі слоти змінені!
Це значна проблема з наївним підходом хешування. Будь-коли
nslots зміни, ми отримуємо абсолютно різні слоти для практично будь-якого предмета. У реалістичній програмі це означає, що щоразу, коли новий вузол приєднується або залишає наш кешуючий кластер, відбуватиметься потік кеш-промахів за кожним запитом, доки новий кластер не заспокоїться. І зміни вузлів іноді відбуваються в самий незручний час; Уявіть, що навантаження різко зростає (можливо, про сайт було згадано в резонансному інформаційному виданні або відбувається пряма трансляція події), і для цього додаються нові вузли. Це не найкращий час для тимчасової втрати кешування!
Послідовне хешування
Послідовний алгоритм хешування вирішує проблему елегантним способом. Ключова ідея полягає в тому, щоб відобразити і вузли, і елементи на інтервалі, а потім елемент належить найближчому до нього вузлу. Конкретно, ми беремо одиничне коло та зіставляємо вузли та елементи з кутами на цьому колі. Ось приклад, який докладніше пояснює, як працює цей метод:
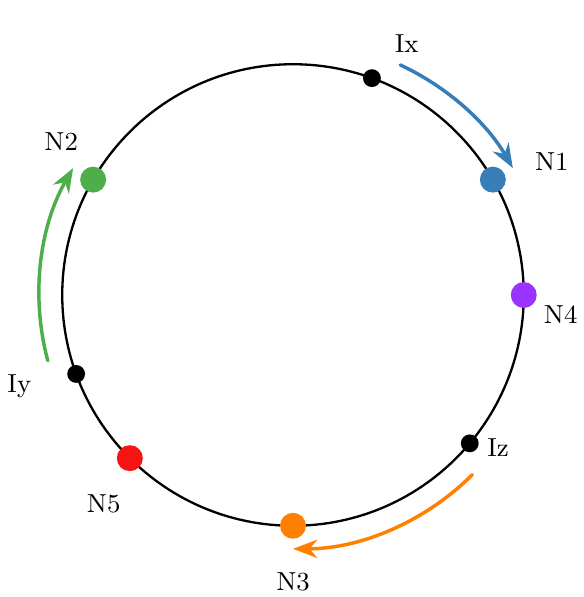
Тут показано п’ять вузлів: від N1 до N5 і три елементи: Ix, Iy, Iz. Спочатку ми додаємо вузли: використовуючи операцію хешування, ми відображаємо їх на коло (подробиці пізніше). Потім, коли елементи надходять, ми визначаємо, до якого вузла вони належать, наступним чином:
- Використовуйте ту саму операцію хешування, щоб знайти розташування елемента в колі
- Вузол, якому належить цей елемент, є найближчим за годинниковою стрілкою
На нашій діаграмі Ix відображається на N1, Iy на N2, а Iz на N3. Поки все добре, але переваги цього підходу стають очевидними, коли вузли змінюються. У нашій діаграмі припустимо, що N3 видалено. Тоді Iz відобразиться на N5.
Відображення інших елементів не змінюється!
Додавання вузлів має аналогічний результат. Якщо додається новий вузол N6 і він хешується до позиції між Iy і N2 на колі, з цього моменту Iy буде зіставлено з N6, але інші елементи збережуть своє відображення.
Припустимо, у нас є всього М предмети, які нам потрібно розподілити Н
вузлів. Використовуючи наївний підхід хешування, коли ми додаємо або видаляємо вузол, усе
М елементи змінюють своє відображення. З іншого боку, при послідовному хешуванні необхідно змінити лише приблизно. Це величезна різниця.
Оригінальний документ про послідовне хешування (див. ) називає це властивість монотонності алгоритму:
Якщо елементи спочатку призначаються набору сегментів, а потім до форми додаються нові контейнери, тоді елемент може переміщуватися зі старого сегмента в новий, але не з одного старого сегмента в інший.
Впровадження узгодженого хешування
Реалізувати узгоджений алгоритм хешування, як описано вище, досить легко. Найважливіша частина реалізації полягає в тому, щоб знайти вузол, на який зіставляється елемент – це передбачає певний пошук. Оригінальний документ про послідовне хешування пропонує використовувати збалансоване бінарне дерево для пошуку; реалізація, яку я тут демонструю, використовує дещо інший, але еквівалентний підхід: бінарний пошук у лінійному масиві позицій вузлів (слотів).
По-перше, деякі практичні міркування:
- Теоретично одиничне коло можна розглядати як безперервний діапазон
(0, 1). Однак у програмуванні ми надаємо перевагу дискретній області, тому ми збираємося «квантувати» цей діапазон, щоб (0, розмір кільця)де
Розмір кільця є деяким достатньо великим числом, яке уникає зіткнень. - Дивлячись на кругову діаграму вище, уявіть, що 0 градусів — це «північ» (12 годин), а кути збільшуються за годинниковою стрілкою. У нашій дискретній області 12 годин – це 0, а 3 години – це Розмір кільця/4і так далі.
Коли вузол додається до узгодженого хешу, його розташування визначається за допомогою хеш-функції, як hashitem як описано вище, с
nslots=розмір кільця. Вузли зберігаються за допомогою пари структур даних, як показано нижче; у цьому прикладі використовуються приблизні розташування вузлів від N1 до N5 на круговій діаграмі вище (припустимо, Розмір кільця=1024 тут):
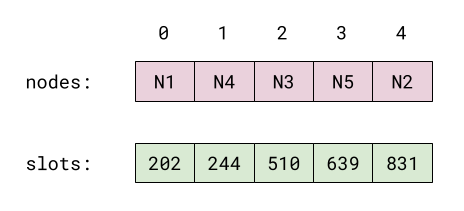
Позиції вузлів на колі зберігаються в слотиякий сортується. вузлів містить відповідні імена вузлів. Для кожного i,
вузли (i) знаходиться на позиції слоти(i) на колі.
Ось ConsistentHasher структура даних у Go:
type ConsistentHasher struct {
  // nodes is a list of nodes in the hash ring; it's sorted in the same order
  // as slots: for each i, the node at index slots(i) is nodes(i).
  nodes ()string

  // slots is a sorted slice of node indices.
  slots ()uint64

  ringSize uint64
}

// NewConsistentHasher creates a new consistent hasher with a given maximal
// ring size.
func NewConsistentHasher(ringSize uint64) *ConsistentHasher {
  return &ConsistentHasher{
    ringSize: ringSize,
  }
}
І ось як реалізовано пошук того вузла, якому даний елемент відповідає:
// FindNodeFor finds the node an item hashes to. It's an error to call this
// method if the hasher doesn't have any nodes.
func (ch *ConsistentHasher) FindNodeFor(item string) string {
  if len(ch.nodes) == 0 {
    panic("FindNodeFor called when ConsistentHasher has no nodes")
  }
  ih := hashItem(item, ch.ringSize)

  // Since ch.slots is a sorted list of all the node indices for our nodes, a
  // binary search is what we need here. ih is mapped to the node that has the
  // same or the next larger node index. slices.BinarySearch does exactly this,
  // by returning the index where the value would be inserted.
  slotIndex, _ := slices.BinarySearch(ch.slots, ih)

  // When the returned index is len(slots), it means the search wrapped
  // around.
  if slotIndex == len(ch.slots) {
    slotIndex = 0
  }

  return ch.nodes(slotIndex)
}
Ключовим тут є виклик бінарного пошуку. Додавання та видалення вузлів виконується аналогічно за допомогою бінарного пошуку – дивіться повний код.
Кращий розподіл предметів за допомогою віртуальних вузлів
Поширеною проблемою, яка виникає під час впровадження узгодженого хешування, є незбалансований розподіл елементів між різними вузлами. З елементами та загальною кількістю вузлів, середній Розподіл буде приблизно на вузол, але на практиці це буде не дуже збалансовано – деякі вузли матимуть набагато більше призначених елементів, ніж інші (дивіться Додаток для отримання додаткової інформації).
У реальній програмі це може означати, що деякі кеш-сервери будуть набагато зайнятіші, ніж інші, що є поганою річчю щодо планування ємності та ефективного використання HW. На щастя, є елегантне налаштування послідовного алгоритму хешування, яке значно пом’якшує проблему: віртуальні вузли.
Замість того, щоб зіставляти кожен вузол з окремим розташуванням кола, ми будемо зіставляти його з В місця натомість. Є кілька способів зробити це – найпростіший – це просто змінити назву вузла якимось чином. Наприклад, коли
AddNode називається додати вузолвін буде працювати:
for i := range V {
  vnodeName = fmt.Sprintf("%v@%v", node, i)

  // ... now add vnodeName to the nodes/slots slices
}
Тоді, під час пошуку елемента ми зіткнемося з одним із віртуальних вузлів, декодуємо назву вузла з нього (у нашому прикладі просто видаліть @
Ідея полягає в тому, що заданий вузол з іменем фуімена віртуальних вузлів
foo@0, foo@1, foo@2 тощо будуть розподілені по всьому колу, а не групуватися в одному місці. Перегляньте Додаток, щоб розрахувати, як це впливає на остаточний розподіл.
Вихідний код цієї публікації містить a ConsistentHasherV тип, який дуже схожий на ConsistentHasherза винятком того, що він реалізує стратегію віртуального вузла. Користувальницький інтерфейс залишився незмінним – дещо змінилася лише внутрішня реалізація.
Код
Повний вихідний код цієї публікації є на GitHub.
Додаток
Якість хеш-функції дуже важлива для гарного перетасування вузлів у колі, але навіть якщо ми візьмемо ідеальну хеш-функцію, яка створює рівномірно розподілені значення, результат, ймовірно, буде неоптимальним для наших потреб.
Скажімо, ми вибираємо точки на одиничному колі рівномірно в діапазоні
(0, 1). Якщо ми відсортуємо точки за кутом, проміжки між сусідніми кутами є статистикою порядку. Вони відповідають бета-розповсюдженню з параметрами (1, N-1)що має середнє значення та дисперсію .
Це досить суттєво. Розглянемо коло з 20 вузлами. Стандартним відхиленням розподілу є квадратний корінь із дисперсії; підставляючи , отримуємо:
З 20 вузлами, рівномірно розподіленими по колу, ми можемо очікувати в середньому 18 градусів відстані між двома вузлами. Стандартне відхилення 0,048 означає 17 градусів, що можна порівняти із середнім!
Ми також можемо навести реалістичний приклад, щоб продемонструвати це. Давайте згенеруємо 20 випадкових кутів на колі та покажемо, як виглядає розподіл вузлів:
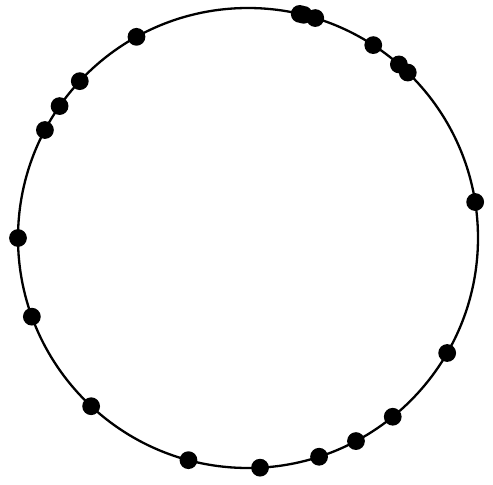
У цьому конкретному зразку середній кут між двома сусідніми вузлами становить 18 градусів (як очікувалося). Найменший кут становить лише 1,04 градуса, а найбільший – 42 градуси. Це означає, що деякі вузли отримають у 40 разів більше елементів, призначених їм, ніж інші!
Легко побачити, як віртуальні вузли допомагають; уявіть, що кожен сервер відображає деяку кількість випадково розподілених вузлів на колі; деякі з них будуть далі, ніж інші, від найближчого сусіда, але в середньому буде набагато менше різноманітності. Математично дано набір п рівномірно розподілені випадкові величини з дисперсією vдисперсія їх середнього становить .
Як конкретний експеримент я запустив симуляцію, подібну до наведеної вище, але з 10 віртуальними вузлами на вузол. Ми розглядатимемо загальну частину кола, що відображається на вузол, коли воно відображається на будь-якому зі своїх віртуальних вузлів. У той час як середнє значення залишається 18 градусів, дисперсія суттєво скорочується – найменша становить 11 градусів, а найбільша – 26.
Ви можете знайти код для цих експериментів у Demo.go файл репозиторію вихідного коду.


