Slowlock
Zo nu en dan hoor je een verhaal als “er was een geval van een 1-Gbps NIC-kaart op een machine die plotseling slechts met 1 Kbps verzond, wat vervolgens een kettingreactie stroomopwaarts veroorzaakte, op zo’n manier dat de prestaties van de gehele werklast van een cluster met 100 knooppunten in een slakkengang kroop, waardoor het systeem in feite niet meer beschikbaar was voor alle praktische doeleinden”. De verhalen zijn interessant en de postmortems zijn leuk om te lezen, maar het is niet echt duidelijk hoe kwetsbaar systemen zijn voor dit soort mislukkingen of hoe vaak deze mislukkingen voorkomen.
De situatie doet me denken aan de mislukkingen van gedistribueerde systemen vóór Jepsen. Er zijn veel anekdotische horrorverhalen, maar een veelvoorkomend antwoord daarop is ‘werkt voor mij’, zelfs als het gaat om systemen waarvan nu bekend is dat ze fantastisch kapot zijn. Een handjevol bedrijven die correctheid echt serieus nemen, beschikt over goede tests en statistieken, maar ze praten er meestal niet publiekelijk over, en het grote publiek heeft geen gemakkelijke manier om erachter te komen of de systemen die ze gebruiken deugdelijk zijn.
Thanh Do et al. hebben geprobeerd hier systematisch naar te kijken – wat is het effect van hardware die kreupel maar niet gedood is, en hoe vaak gebeurt dit in de praktijk? Het blijkt dat veel veelgebruikte systemen niet bestand zijn tegen ‘hinkende’ hardware, maar dat dit soort fouten zelden voorkomen (tenminste totdat je een onredelijk grote schaal hebt).
Het effect van een enkel langzaam knooppunt kan behoorlijk dramatisch zijn:
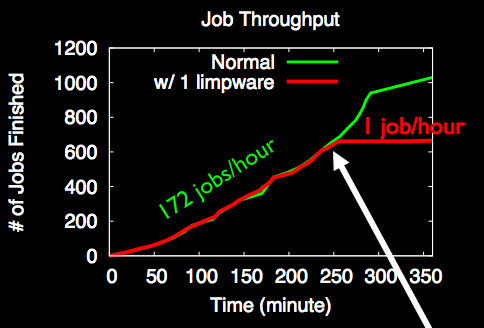
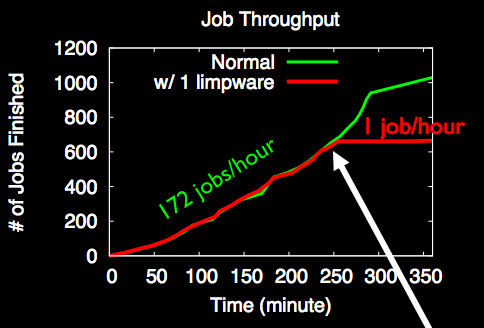
Het voltooiingspercentage van taken daalde van 172 taken per uur naar 1 taak per uur, waardoor feitelijk het hele cluster omkwam. Facebook heeft mechanismen om met dode machines om te gaan, maar blijkbaar hadden ze destijds geen enkele manier om met trage machines om te gaan.
Wanneer Do et al. Ze keken naar veelgebruikte open source-software (HDFS, Hadoop, ZooKeeper, Cassandra en HBase) en ontdekten soortgelijke problemen.
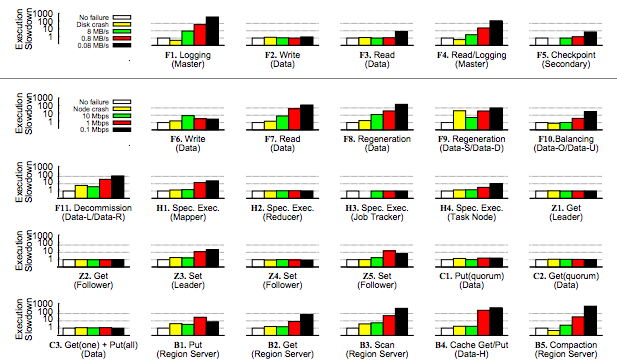
Elke subgrafiek is een andere faalconditie. F is HDFS, H is Hadoop, Z is Zookeeper, C is Cassandra en B is HBase. De meest linkse (witte) balk is het geval van geen storing op de basislijn. Als u naar rechts gaat, is de volgende crash, en de daaropvolgende balken zijn resultaten voor een enkele defecte maar niet gecrashte hardware (verder naar rechts betekent langzamer). In de meeste (maar niet alle) gevallen beïnvloedde het hebben van slechte hardware de prestaties veel meer dan het hebben van defecte hardware. Merk op dat deze grafieken allemaal op logschaal zijn; Eén stap omhoog gaan is een prestatieverschil van 10x!
Vreemd genoeg kan een defecte schijf ervoor zorgen dat sommige bewerkingen sneller verlopen. Dat komt omdat er bewerkingen zijn die minder replicatieoverhead hebben als een replica mislukt. Het lijkt mij een beetje raar dat er niet meer overhead is, omdat het systeem zowel een vervangende replica moet vinden als gegevens moet repliceren, maar wat weet ik?
Hoe dan ook, waarom is een langzaam knooppunt zoveel erger dan een dood knooppunt? De auteurs definiëren drie faalwijzen en leggen uit wat de oorzaak is van elk daarvan. Er is operatie limplock, wanneer een bewerking traag is omdat een subdeel van de bewerking langzaam is (bijvoorbeeld het lezen van een schijf is traag omdat de schijf is beschadigd), node limplock, wanneer een knooppunt traag is, zelfs voor ogenschijnlijk niet-gerelateerde bewerkingen (bijvoorbeeld het lezen van RAM is traag omdat een schijf is beschadigd), en cluster limplock, waarbij het hele cluster traag is (bijvoorbeeld een enkele defecte schijf maakt een volledig cluster van 1000 machines traag).
Hoe gebeuren deze?
Operatie Limplock
Deze is de eenvoudigste. Als u van schijf probeert te lezen en uw schijf is traag, dan zal het lezen van de schijf ook langzaam zijn. In de echte wereld zullen we dit zien wanneer operaties één enkel storingspunt hebben, en wanneer monitoring is ontworpen om totale mislukkingen op te vangen en niet verminderde prestaties. Een HBase-toegang tot een regio loopt bijvoorbeeld via de server die verantwoordelijk is voor die regio. De gegevens worden gerepliceerd op HDFS, maar dit helpt u niet als het knooppunt dat eigenaar is van de gegevens hinkt. Over HDFS gesproken, het heeft een time-out van 60 seconden en de leesbewerkingen zijn in stukjes van 64K, wat betekent dat je leesbewerkingen kunnen vertragen tot bijna 1K/s voordat HDFS zal overgaan naar een gezond knooppunt.
Knooppunt Limplock
Hoe kan het zo zijn dat (bijvoorbeeld) een trage schijf ervoor zorgt dat het lezen van het geheugen traag verloopt? Als we opnieuw naar HDFS kijken, wordt er gebruik gemaakt van een threadpool. Als elke thread heel langzaam bezig is met het voltooien van een schijflezing, worden geheugenlezingen geblokkeerd totdat een thread vrijkomt.
Dit is niet alleen een probleem bij het gebruik van beperkte threadpools of andere begrensde abstracties – de realiteit is dat machines eindige bronnen hebben, en onbegrensde abstracties zullen tegen machinelimieten aanlopen als ze niet zorgvuldig zijn ontworpen om de mogelijkheid te vermijden. Zookeeper houdt bijvoorbeeld een wachtrij bij van bewerkingen, en een langzame volger kan ervoor zorgen dat de wachtrij van de leider het fysieke geheugen uitput.
Cluster Limplock
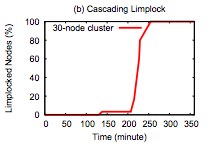
Een heel cluster kan gemakkelijk ongezond worden als het afhankelijk is van een enkele primaire cluster en de primaire hinkt. Trapsgewijze fouten kunnen dit ook veroorzaken: de eerste grafiek, waarin een cluster van het voltooien van 172 taken per uur naar 1 taak per uur gaat, is eigenlijk een Facebook-werklast op Hadoop. Wat voor mij hier verrassend is, is dat Hadoop staarttolerant zou moeten zijn; individuele langzame taken mogen geen grote impact hebben op de voltooiing van de hele klus. Dus wat is er gebeurd? Ongezonde knooppunten infecteren gezonde knooppunten en sluiten uiteindelijk het hele cluster op.
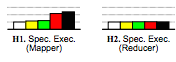
De staarttolerantie van Hadoop komt voort uit het starten van speculatieve berekeningen wanneer de resultaten langzaam binnenkomen. In het bijzonder wanneer achterblijvers ongewoon langzaam binnenkomen in vergelijking met andere resultaten. Dit werkt prima wanneer een reduceerknooppunt hinkt (subgrafiek H2), maar wanneer een kaartknooppunt hinkt (subgrafiek H1), kan het alle reducers in dezelfde taak vertragen, wat de staarttolerantiemechanismen van Hadoop tenietdoet.
Om te zien waarom, moeten we naar het speculatie-algoritme van Hadoop kijken. Elke taak heeft een voortgangsscore die een getal tussen 0 en 1 (inclusief) is. Voor een kaart is de score de fractie van de gelezen invoergegevens. Voor een reductie krijgt elk van de drie fasen (gegevens van mappers kopiëren, sorteren en verkleinen) 1/3 van de score. Een speculatieve taak wordt uitgevoerd als een taak ten minste één minuut is uitgevoerd en een voortgangsscore heeft die lager is dan het gemiddelde voor de betreffende categorie minus 0,2.
In geval H2 loopt de NIC mank, zodat de kaartfase normaal wordt voltooid, aangezien de resultaten uiteindelijk naar de lokale schijf worden geschreven. Maar wanneer reducerende knooppunten gegevens proberen op te halen van het hinkende kaartknooppunt, lopen ze allemaal vast, waardoor de gemiddelde score voor de categorie omlaag gaat, waardoor speculatieve taken niet kunnen worden uitgevoerd. Als we naar het grote geheel kijken, heeft elk Hadoop-knooppunt een beperkt aantal kaarten en minder taken. Als deze vollopen met hinkende taken, zal het hele knooppunt vastlopen. Omdat Hadoop niet is ontworpen om trapsgewijze fouten te voorkomen, zorgt dit er uiteindelijk voor dat het hele cluster vastloopt.
Eén ding dat ik interessant vind, is dat deze exacte oorzaak van mislukkingen werd beschreven in het originele MapReduce-artikel, gepubliceerd in 2004. Ze noemden zelfs expliciet trage schijven en netwerken als oorzaken van achterblijvers, wat hun speculatieve uitvoeringsalgoritme motiveerde. Ze verstrekten echter niet de details van het algoritme. De open source kloon van MapReduce, Hadoop, probeerde hetzelfde probleem te vermijden. Hadoop werd voor het eerst uitgebracht in 2008. Vijf jaar later, toen het artikel dat we lezen werd gepubliceerd, slaagde het ingebouwde mechanisme voor achterblijversdetectie er niet alleen niet in om meerdere typen achterblijvers te voorkomen, maar ook niet om te voorkomen dat achterblijvers het hele cluster effectief in een impasse brachten.
Conclusie
Ik ga niet in details treden over hoe elk systeem het tijdens de tests heeft gedaan. Dat staat heel mooi beschreven in de krant, en ik raad je aan de krant te lezen als je nieuwsgierig bent. Samenvattend: Cassandra doet het redelijk goed, terwijl HDFS, Hadoop en HBase dat niet doen.
Cassandra lijkt het om twee redenen goed te doen. Ten eerste voorkomt deze patch uit 2009 dat wachtrij-overflows gezonde knooppunten infecteren, waardoor een grote storingsmodus wordt voorkomen die clusterbrede storingen in andere systemen veroorzaakt. Ten tweede ontkoppelt de gebruikte architectuur (SEDA) verschillende soorten operaties, waardoor goede operaties kunnen blijven worden uitgevoerd, zelfs als sommige operaties haperen.
Mijn grote vragen na het lezen van dit artikel zijn: hoe vaak komen dit soort mislukkingen voor, hoe, en hoe zouden redelijke statistieken/rapportage dit soort dingen toch niet moeten onderkennen?
Voor het antwoord op de eerste vraag hebben veel van dezelfde auteurs ook een artikel waarin ze naar 3000 fouten in Cassandra, Flume, HDFS en ZooKeeper keken en bepaalden welke fouten hardware-gerelateerd waren en wat de hardwarefout was.
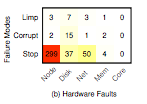
14 gevallen van verminderde prestaties versus 410 andere hardwarefouten. In hun steekproef is dat 3% van de mislukkingen; zeldzaam, maar niet zo zeldzaam dat we het probleem kunnen negeren.
Als we dit soort fouten niet kunnen negeren, hoe kunnen we ze dan opsporen voordat ze in productie gaan? Het papier maakt gebruik van het Emulab-testbed, wat echt gaaf is. Helaas staat op de Emulab-pagina: “Emulab is een openbare voorziening, gratis beschikbaar voor de meeste onderzoekers wereldwijd. Als u niet zeker weet of u in aanmerking komt voor gebruik, raadpleeg dan ons beleidsdocument of vraag het ons. Als u denkt dat u in aanmerking komt, kunt u een aanvraag indienen om een nieuw project te starten.” Dat is begrijpelijk, maar dat betekent dat het voor de meesten van ons waarschijnlijk geen geweldige oplossing is.
De overgrote meerderheid van haperende hardware is te wijten aan netwerk- of schijftraagheid. Waarom zou een aangepaste versie van Jepsen, of iets dergelijks, de schijf- of netwerktraagheid niet kunnen simuleren? Een naïeve implementatie zou bij lange na niet in de buurt komen van de nauwkeurigheid van Emulab, maar aangezien we het hebben over vertragingen van een orde van grootte, zou een variantie van 10% (of zelfs 2x) voldoende moeten zijn om de robuustheid van systemen te testen ten opzichte van gedegradeerde hardware. Er zijn een aantal manieren waarop je je kunt voorstellen dat dit werkt. Om bijvoorbeeld een langzaam netwerk op Linux te simuleren, zou je kunnen proberen throttling via qdisc, syscalls aan te sluiten via ptrace, enz. Voor een trage CPU kun je rate-limit gebruiken via cgroups en cpu.shares, of het proces gewoon toewijzen aan UC-geheugen (of misschien WT of WC als dat een beetje te langzaam is), enzovoort, enzovoort voor schijf- en andere foutmodi.
Dan blijft mijn laatste vraag over: zouden systemen dit soort fouten niet al moeten opvangen, zelfs als ze zich daar niet in het bijzonder zorgen over maken? Zoals we hierboven hebben gezien, zijn systemen met verlammend trage hardware zo zeldzaam dat we ze gewoon als dood kunnen beschouwen zonder een significante impact op onze totale computerbronnen. En systemen met defecte hardware kunnen vrij eenvoudig worden gedetecteerd. Bovendien moeten multi-tenantsystemen hun eigen prestaties voortdurend monitoren om toch een goede benutting te krijgen.
Dus waarom zouden we ons druk maken over het ontwerpen van systemen die robuust zijn tegen hinkende hardware? Een deel van het antwoord is diepgaande verdediging. Natuurlijk moeten we over monitoring beschikken, maar we moeten ook over systemen beschikken die robuust zijn als onze monitoring faalt, wat onvermijdelijk zal gebeuren. Een ander deel van het antwoord is dat door systemen toleranter te maken voor haperende hardware, we ze ook toleranter zullen maken voor interferentie van andere werklasten in een omgeving met meerdere tenants. Dat laatste is een enigszins speculatieve empirische vraag: het is mogelijk dat het efficiënter is om systemen te ontwerpen die niet bijzonder robuust zijn tegen interferentie van concurrerend werk op dezelfde machine, terwijl ze betere partities gebruiken om interferentie te voorkomen.
Met dank aan Leah Hanson, Hari Angepat, Laura Lindzey, Julia Evans en James M. Lee voor commentaar/discussie.


