Biaya Inferensi Tidak Berkelanjutan

Biaya Inferensi Tidak Berkelanjutan

Biaya Inferensi Tidak Berkelanjutan

Ya, sekarang saya menyelesaikan seperempat langganan MAX minggu saya dalam beberapa jam bekerja dengan Claude Code.

Menurutku Anthropic itu pintar, dan menurutku mereka tidak mencoba menipu kita. Saya pikir sejujurnya mereka hanya mencoba menyelaraskan tuduhan inferensi dengan kenyataan.

Dan hal ini harus menjadi peringatan bagi kita semua.

Saya pikir kita akan membutuhkan multi-model harness (atau model bagus yang JAUH lebih murah dalam satu platform), seperti Haiku 20x lebih murah atau apa pun.

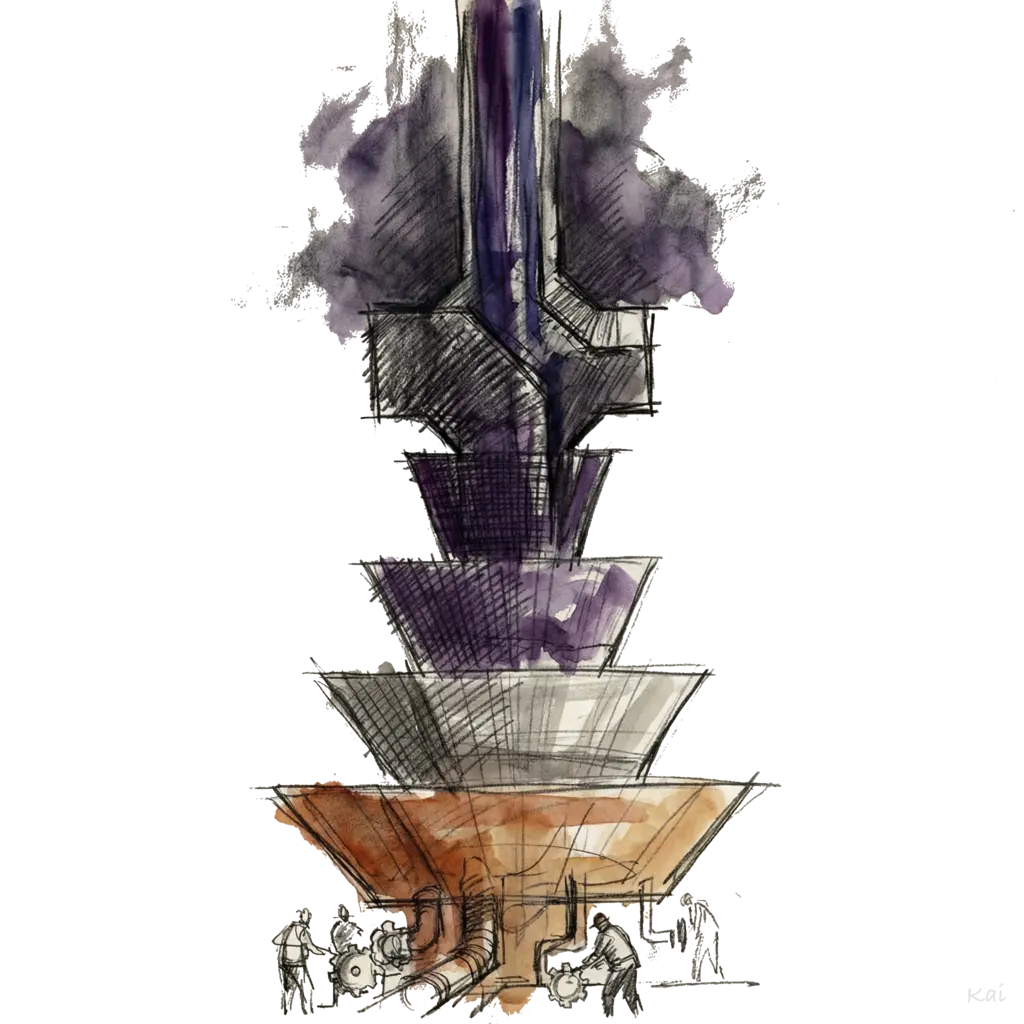
Hal ini tidak berkelanjutan.

Semakin baik tali pengaman dan modelnya, semakin banyak orang yang akan membangunnya. Yang akan membutuhkan lebih banyak inferensi.

Saya pikir solusi nyata di sini akan datang dari:

  • Teknologi seperti Cerberus, dkk yang membuat inferensi berkali-kali lebih murah dan cepat

  • Dorongan besar dari laboratorium besar untuk menghasilkan kualitas yang lebih tinggi dalam model yang jauh lebih kecil/lebih murah

  • Memanfaatkan peralihan ke model hibrida berbayar/cloud dan lokal/murah.

Jika ini terus berlanjut, saya harus membuat PAI versi kustom saya sendiri menggunakan Pi, yang dapat menggunakan model lokal pada dual 4090 saya, model seperti Gemini-Flash, model seperti Gemma 4, dll.

Dan yang paling penting, infra kait baru yang menilai tugas dan mengarahkan dengan benar ke model yang tepat.

  • Maks: Opus / GPT-5.4
  • Tinggi: Soneta
  • Sedang: Haiku
  • Rendah: (Lokal) Apapun model OSS terbaru terbaik yang dapat berjalan di NVIDIA / Mac Silicon saya

Saya pikir kita semua tahu hal ini akan terjadi; Saya hanya berpikir itu akan terjadi pada tahun 2027 nanti. Dan lebih lembut.

Tampaknya hal ini sudah sangat dekat karena subsidi sebesar ini tampaknya tidak berkelanjutan bagi Anthropic, yang berarti mungkin juga tidak berkelanjutan bagi OpenAI.

Rekomendasi saya: Mulailah merencanakan strategi model Multi / Lokal / Lebih Murah untuk harness Anda.


Source link

Postagens Similares

  • 個人的なAPIの構築|ダニエル・ミスラー

    の(非常に早い)最初のバージョンを起動するのに超宣伝されています デーモン 今日! 2014年以来、私はすべてがAPIを持っているというこの考えに夢中になっています。私は2016年に私の(ちょっと安っぽいが素晴らしいアイデアを持って)本物のモノのインターネットで最初にそれについて話しました。 したがって、これは最初のビルディングブロックです。すべてのオブジェクトにはデーモンがあります。他のすべてのオブジェクトが理解している世界へのAPIです。コンピューター、システム、または適切なアクセスを持つ人間でさえ、他のオブジェクトのデーモンを見て、それとどのように対話するか、そのステータスが何であるか、何ができるかを正確に知ることができます。 The Real Thingのインターネット、2016年 アイデアは、車やレストランのようなオブジェクトだけでなく、デーモンズ/アピスだけでなく、人々でもあるということでした。 最も重要なことは、人間自身もデーモンを持っていることであり、私たちは他のデーモンでいっぱいの世界を移動することです。 Human Daemonsは、タイプ、感度、アクセス制限などに基づいて区分化された人物に関するすべての情報を保持し、そのデータを使用して、私たちの周りのDaemonsに超個人化された要求を送信します。 The Real Thingのインターネット、2016年 デジタルアシスタントと組み合わせる そして、それは他の主要な概念でクリックしました。つまり、人間としてそれを行う方法がないので、常に「私たちの周りに」常に「私たちの周り」にあるこれらの何千ものAPIを常に処理するAIを搭載したデジタルアシスタント(DA)があります。 私はこの文脈に永遠に夢中になっています。 合成インテリジェンスが近い将来に果たす最も目に見える重要な役割は、人間と世界の間のインターフェースとして機能することです。 明確にするために、私は非常に多くのサイエンスフィクションが基づいているSIの絶えず推奨され、意識的で自己改善されたブランドを意味するものではありません。 私が言及しているSIは、人間のコンテキスト、意図、コマンドを監視し、それらを解釈してから、(人間の)プロのパーソナルアシスタント以上の行動をとることができるコンピューターシステムです。 The Real Thingのインターネット、2016年 したがって、DASはTechを使用して私たちの周りのものと根本的にどのように相互作用するかを根本的に変えるという考えでした。私たちのデバイスを使用してそれを行う代わりに、それはスケーリングしない、私たちのDASは私たちのためにそれをしているでしょう。 テクノロジーと直接対話する代わりに、DAと対話し、DAは必要なデーモンで詳細を解決します。私たちは話します、物事が起こります。私たちはジェスチャーします、物事が起こります。私たちはテキストで、物事が起こります。新しい技術を見つけたり、理解したり、習得したりする必要はありません。それは、サービスとDAが自分自身の間でうまくいくためです。 The Real Thingのインターネット、2016年 実際にはうまくいくと思います したがって、具体的には、私がいつも考えているユースケースは、あなたが独身であるコーヒーショップであり、あなたのDAはあなたが関係を探していることを知っており、あなたが歩いて、それは店のすべてのデーモンを読みます。 あなたはスターバックスで並んで待っています、そして、カイ(あなたのDA)はあなたの周りのすべての公共のデーモン(物)とオーラ(人々)を継続的に読んでいます。彼女は非常に多くのことに合わせているので、カイはあなたの前の女の子を照らします。 7/9お気に入りの読書マッチ 恥ずかしがり屋であるが、関係は愛情深い 犬>猫 😍彼女は大声で噛む人々を殺すことは合法であるべきだと信じています カイは話し始めます 彼女 ダ、タラ、そして今、彼とタラはあなたが部屋の向こうからお互いを見るように、どこを見るべきかをあなたに伝えようとしています。 日常のオブジェクトでさえ、独自のオーラを持っています 私はまだデータコンテンツについて多くのことをしていません。 したがって、デーモンは私の初期バージョンです。これは、人間とAIの両方が使用できる形式で私に関する最新の情報を提供するパブリックエンドポイントです。 建築 CloudFlare MCPのデーモンアーキテクチャ そして、これが相互作用の仕組みの大まかな内訳です​​。 CloudFlareワーカーのデーモンMCPアーキテクチャ(フルサイズのためにクリック) それを使用する方法 デーモンはMCP(モデルコンテキストプロトコル)サーバーとして実行されます https://daemon.danielmiessler.com。これと対話する方法は次のとおりです。 利用可能なツールを取得します まず、使用可能なエンドポイントをご覧ください。 バッシュ curl -X…

  • WikipediaのブラックリストArchive.today、695,000のアーカイブリンクの削除を開始

    物議を醸しているアーカイブ サイトがブログに対する分散型サービス拒否 (DDoS) 攻撃を指示するために使用されたことを受け、英語版ウィキペディアは Archive.today をブラックリストに登録しました。 DDoS を理由に Archive.today を廃止すべきかどうかを議論する過程で、Wikipedia 編集者は、アーカイブ サイトが Web ページのスナップショットを変更して DDoS の標的となったブロガーの名前を挿入していたことを発見しました。この改変は明らかに、Archive.today の管理者が複数のエイリアスで自分の身元を隠した方法を説明した投稿に対するブロガーに対する恨みによって煽られたようです。 「archive.today をただちに非推奨にし、実行可能な限り速やかにスパム ブラックリストに追加し (または新しいリンクの追加をブロックする編集フィルターを作成し)、そこへのすべてのリンクを削除するという合意が得られています」と、今日の Wikipedia の Archive.today ディスカッションの最新情報には記載されています。 「ユーザーのコンピュータを乗っ取ってDDoS攻撃を実行するようなWebサイトにWikipediaが読者を誘導すべきではないという強いコンセンサスがある(WP:ELNO#3を参照)。さらに、archive.todayの運営者がアーカイブされたページのコンテンツを改変し、信頼性を失わせたという証拠も提示されている。」 Archive.today への 695,000 を超えるリンクが、約 400,000 の Wikipedia ページに分散されています。アーカイブ サイトは、ニュース ペイウォールをバイパスするためによく使用されます。彼はFBIを持っています 求めた情報 サイト運営者の身元について、ドメイン登録業者 Tucows への召喚状を提出します。 「現状維持を支持する人たちは、主に検証可能性のための archive.today の有用性に議論を置いた」とウィキペディアの今日の更新には書かれている。 「しかし、既存のリンクの分析により、その用途のほとんどは置き換えられることがわかりました。この RfC (コメント要求) 中に数人の編集者が実装の詳細を検討し始めました。コミュニティは、archive.today へのリンクを効率的に削除する方法を見つけ出す必要があります。」 編集者はリンクを削除するよう要請 この決定の結果として公開されたガイダンスでは、アーカイブ サイトで使用されている次のドメイン名へのリンクを削除および置換するよう編集者に協力するよう求めています: archive.today、archive.is、archive.ph、archive.fo、archive.li、archive.md、および archive.vn。ガイダンスでは、元のソースがまだオンラインであり、内容が同一である場合、編集者は Archive.today のリンクを削除できると記載されています。アーカイブ…

  • Beberapa menit dengan Hanselman

    Scott Hanselman, Wakil Presiden Microsoft untuk penjangkauan komunitas pengembang dan orang baik secara umum, berbaik hati meminta saya untuk hadir di podcastnya, HanselMinutes, untuk membicarakan buku saya yang akan datang. Saya senang menghabiskan beberapa menit mengobrol dengan Scott tentang penulisan, keadaan alat pengembang, dan sebagainya. Jika Anda ingin memeriksanya, gunakan tautan di atas, atau video…

  • Covid-19 预估更新 2020 年 8 月 23 日 – CDC 预测中包含预估

    估计感染死亡人数和死亡率 如果我们知道感染人数,并且知道感染死亡率(IFR),那么从感染人数预测死亡人数就会非常简单。然而,在整个大流行期间,我们一直在估计感染人数和 IFR,但在许多情况下做得很糟糕。各州的数字似乎也有很大差异。 IFR 约为 0.5% 我在 Medium 上的一篇文章中解释了我是如何得出这个结论的。超级快速的解释是,这个数字至少可以根据纽约州 4 月下旬进行的抗体测试,结合纽约州因 Covid-19 死亡的信息来计算出来。一旦我们知道了大概的 IFR,我们就可以引导根据死亡人数估计感染人数的方法,这有助于我们将阳性检测与感染之间的关系归零。 检测呈阳性并不等于感染 阳性检测和感染不是一回事。阳性检测是感染数量的有用指标,但它们并不相同。这个简单的概念似乎阻碍了许多所做的估计。 随着时间的推移,阳性检测与感染之间的关系一直在发生变化。在大流行初期,感染与阳性检测的比例似乎在 10:1 到 20:1 之间。现在这个比例似乎在 3:1 到 5:1 的范围内。 单纯病死率 我的估计方法的基石是跟踪 Naive CFR 的变化,作为感染与阳性检测比率的指标。 单纯病死率 计算方法是今天的死亡人数除以 14 天前的阳性检测人数。由于死亡滞后于阳性检测,因此阳性检测是未来死亡的有用先行指标。 我仍然对许多广为人知的短期死亡率估计的巨大错误感到惊讶。如果您仅采用过去 7 天的平均初始病死率 (naive CFR),并根据 14 天滞后的阳性检测结果,用它来估计未来 14 天的死亡人数,那么您可以对未来 14 天的死亡人数做出比已发布的绝大多数估计更准确的估计。 对于截至 8 月 1 日左右的估计,我使用了阳性测试百分比(阳性率)和幼稚 CFR 之间的强相关性。因为我们在报告测试数据时知道测试阳性率,所以它作为死亡率的领先指标非常有用,而且我使用最近的阳性率以及阳性测试的数量来估计近期未来的死亡率。 但自大流行开始以来,单纯病死率已大幅下降。一开始超过50%,8月初一度跌至1.4%。随着 Naive CFR…

  • విద్యుత్ జలశక్తి

    నేను ఎప్పుడూ నన్ను “కారు వ్యక్తి” గా భావించలేదు. నేను కొన్న చివరి కొత్త కారు (మరియు వాస్తవానికి, ఇప్పుడు నేను దాని గురించి ఆలోచిస్తున్నాను మొదట నేను ఎప్పుడైనా కొన్న కొత్త కారు) చమత్కారమైన 1998 ఫోర్డ్ కాంటూర్ SVT. అప్పటి నుండి, మేము 2011 లో విడబ్ల్యు స్టేషన్ బండిని మరియు కుటుంబ రవాణా విధుల కోసం 2012 లో హోండా మినివాన్‌ను కొనుగోలు చేసాము. అంతే. స్టిగ్ యొక్క కలలు తయారు చేయబడిన…

Deixe um comentário

O seu endereço de email não será publicado. Campos obrigatórios marcados com *