Прогнозы моей ансамблевой модели CDC по Covid-19 — обновление на 05.09.20
Оценка смертности от инфекций и уровня смертности
Если бы мы знали количество инфекций и знали уровень смертности от инфекций (IFR), было бы очень просто спрогнозировать количество смертей на основе количества инфекций. Однако на протяжении всей пандемии мы оценивали как количество инфекций, так и IFR, и во многих случаях делали это плохо. Цифры также сильно различаются от штата к штату.
IFR находится в районе 0,5%.
Я объяснил, как пришел к такому выводу, в статье на Medium. Очень быстрое объяснение заключается в том, что это число можно рассчитать, по крайней мере приблизительно, на основе тестов на антитела, которые штат Нью-Йорк провел в конце апреля, в сочетании с информацией о смертельных случаях в штате Нью-Йорк от Covid-19. Как только мы узнаем приблизительный IFR, мы сможем запустить методы оценки количества инфекций на основе количества смертей, и это поможет нам сосредоточиться на взаимосвязи между положительными тестами и инфекциями.
Положительные тесты не равны инфекциям
Положительные тесты и инфекции – это не одно и то же. Положительные тесты являются полезным показателем количества инфекций, но это не одно и то же. Эта простая концепция, похоже, противоречит многим сделанным оценкам.
Связь между положительными тестами и инфекциями со временем меняется. В начале пандемии выяснилось, что соотношение заражений к положительным тестам находилось где-то между 10:1 и 20:1. Сейчас соотношение находится где-то в диапазоне от 3:1 до 5:1.
Наивный CFR
Краеугольным камнем моих подходов к оценке было отслеживание изменений наивного CFR как индикатора соотношения инфекций и положительных тестов. Наивный CFR рассчитывается как число сегодняшних смертей, разделенное на положительные тесты 14 дней назад. Поскольку смертность отстает от положительных результатов тестов, положительные тесты являются полезным опережающим индикатором будущих смертей.
Я продолжаю удивляться огромной неточности многих широко разрекламированных краткосрочных оценок смертности. Если вы просто возьмете средний наивный CFR за последние 7 дней и используете его для оценки смертности в течение следующих 14 дней на основе положительных результатов тестов с запаздыванием в 14 дней, вы получите более точные оценки смертности в течение следующих 14 дней, чем подавляющее большинство опубликованных оценок.
Для своих оценок примерно до 1 августа я использовал сильную корреляцию между процентом положительных результатов тестов (положительностью) и наивным CFR. Поскольку мы знаем о положительном результате теста, когда сообщаются данные теста, он оказался полезным в качестве ведущего индикатора уровня смертности, и я использовал недавние положительные результаты вместе с количеством положительных тестов для оценки уровня смертности в ближайшем будущем.
Однако с начала пандемии уровень Naive CFR резко снизился. Вначале он составлял более 50%, а в начале августа на какое-то время упал до 1,4%. Поскольку наивный CFR снизился, позитивность стала менее полезной в качестве основы для оценки.
Главный фактор, который изменился, заключается в том, что средний возраст людей, проходящих тестирование, имеет тенденцию к снижению. Процент людей в возрасте до 50 лет с положительным результатом теста также тесно коррелирует с наивным CFR. CDC сообщает эту информацию, но не очень своевременно. Он отстает примерно на 2 недели, если вообще будет опубликован.
Обновленная методология оценки
Из-за неопределенности в модели позитивности я вернулся к использованию нескольких методов оценки и сравнению результатов.
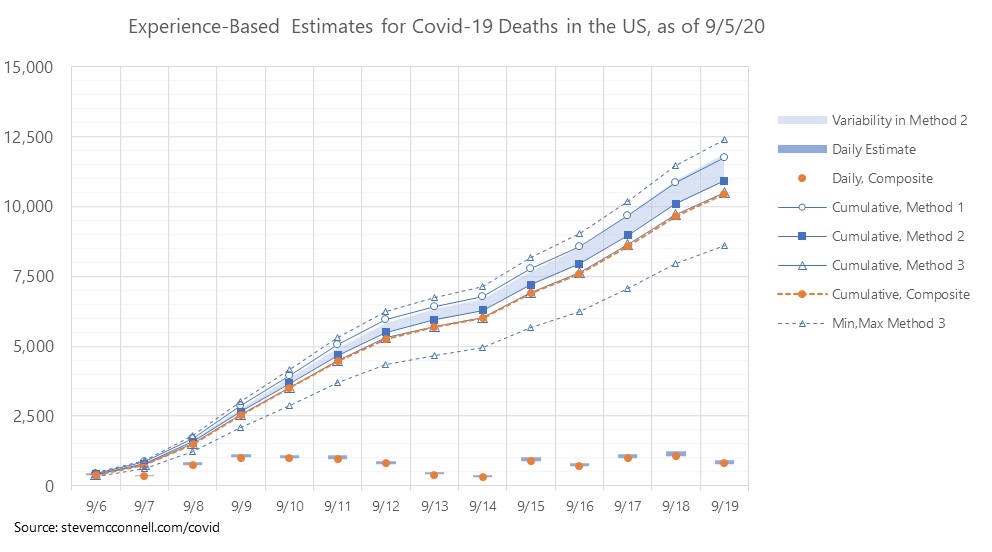
Способ 1 – Это похоже на метод, который я только что описал. Это модель с аппроксимацией кривой, основанная на (а) проценте положительных результатов тестов (положительности) и (б) тенденции среднего возраста испытуемых. Оба этих фактора имеют высокие значения RSQ по сравнению с наивным CFR, но по мере того, как средний возраст имеет тенденцию к снижению, часть (a) модели становится менее точной, а часть (b) – более точной, хотя ни один из них не был сверхточным в течение последних 5-6 недель. Мне также было трудно найти свежую информацию о возрасте людей, проходящих тестирование. Основными входными данными для этой модели являются положительные тестовые случаи, произошедшие за 14 дней до предполагаемой даты смерти.
Способ 2 – Этот метод основан на анализе тенденций Naive CFR. Я беру историю недавних Naive CFR, рассчитываю линию тренда и проецирую ее вперед. Затем я ежедневно применяю оценки будущих Наивных CFR к положительным тестам, полученным 14 днями ранее. Задача при таком подходе состоит в том, чтобы решить который Наивная тенденция использования CFR. Цифры могут сильно различаться в зависимости от того, как рассчитывается тренд. Я начинаю с ежедневных сглаженных простых CFR (на основе 7-дневного сглаживания). Используя эти данные, я делаю один прогноз на основе среднего арифметического значения Naive CFR за одну неделю, один — на основе среднего арифметического значения Naive CFR за две недели и один — на основе среднего арифметического среднего геометрического CFR за 7 и 14 дней.
Способ 3 – Это сумма государственных смет. Теперь я включаю доверительные интервалы в оценки на основе штатов, которые учитывают максимум и минимум.
По мере того, как я больше работаю над оценками штата, я начинаю больше доверять тому, что они в сумме приближаются к национальной оценке. Я начинаю больше смотреть на то, является ли изменчивость в результате построения состояния более точной или изменчивость в рамках метода 2 или в результате комбинации метода 1 и метода 2.
Композитная модель – Составная модель представляет собой среднее значение Метода 1, Метода 3 и минимального числа из Метода 2. Затем она подвергается точной настройке на ежедневной основе для учета истории ежедневных колебаний в отчетности.


